
Мультимодальні ембеддінги: CLIP! Просто додай води!
Невеличкий додаток до серії про векторні БД — тема, яка не дуже влізла у попередні дві статті про інгестію і деградацію, але варта окремої розмови. Якщо після всього попереднього ви подумали "ок, з текстом розібрались, а як щодо зображень та інших типів контенту?" — ця стаття саме про це.
Мультимодальний пошук на папері звучить як майбутнє (це вже в нас рефреном починає проходити, да?). Демки показують, як ви пишете "червона сукня з квітами", і система знаходить фото червоних суконь з квітами, як ви завантажуєте фото, і система знаходить схожі, або як воно шукає у PDF-ах з картинками, графіками, діаграмами.
Більше того, одна з перших статей в цьому блозі саме таке і показувала: на картинках з Караулом Смерті космодесантники такі. Красіво, душевно, уалшебно, на YouTube туторіалі чи на Medium виглядають такі демо просто ідеально.
На практиці — ми колективно досі в стані "працює, але з дуже конкретними обмеженнями, і ці обмеження не очевидні, поки не бахнешся об них головою сам". Якщо ви вирішили будувати щось мультимодальне поверх RAG — є три грабельки, про які варто знати заздалегідь, щоб не розчаровуватися через півроку, коли воно не робе.
CLIP як відправна точка
Що таке CLIP взагалі? CLIP (Contrastive Language-Image Pre-training) від OpenAI, 2021 — піонер сучасного підходу до мультимодальних ембеддінгів. Ідея проста: два окремі енкодери, один для картинок (зазвичай ViT або ResNet), один для тексту (Transformer). Тренуються спільно на мільярдах пар картинка-підпис так, щоб ембеддінги семантично схожих пар опинялися близько у спільному просторі.
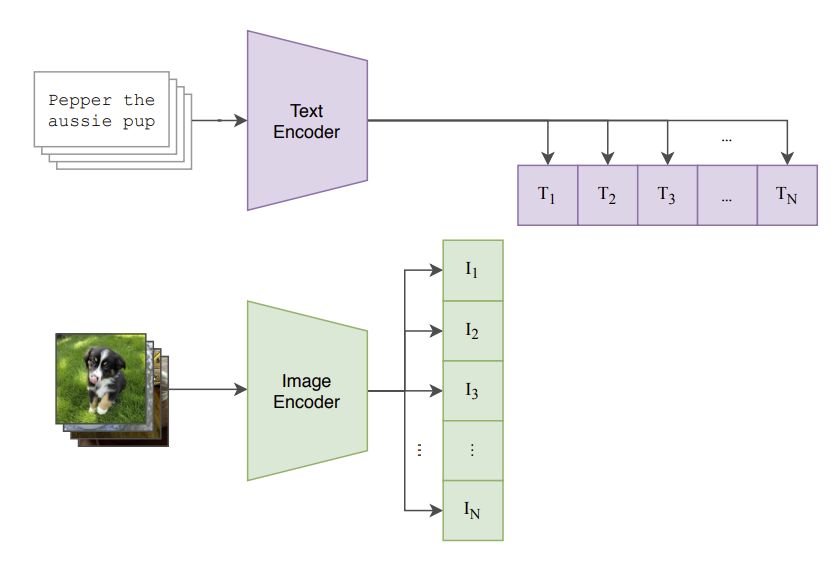
Що це дозволяє робити? Шукаєш текстом "фото кота" — знаходиш фото котів. Шукаєш картинкою — знаходиш схожі картинки. Шукаєш "собака біжить по траві" — знаходиш такі фото. Один embedding space на обидві модальності (тут модальність саме як відношення інпуту до об'єктів пошуку і способу існування цих об'єктів): будь-який запит у будь-якій модальності шукає по обох, і по зображенню, і по текстовій репрезентації.
Звучить просто пушка, правда? Дешевше сховище і інфраструктура простіша (одна модель замість двох), простий API, масштабується на будь-який обсяг даних, з реалістичних. Ну і загалом для простих задач типу "знайди візуально схожі товари в e-commerce" воно дійсно працює добре.
Але як тільки ви починаєте будувати щось складніше або що не вкладається в такий юзкейс — піднімають голову три проблеми CLIP.
Проблема 1: обмеження на текст
Що відбувається? CLIP приймає максимум 77 токенів тексту — це жорсткий ліміт архітектури. Але — і це не зовсім очевидна деталь — емпірично модель не використовує більше ніж ~20 токенів для генерації повноцінних ембеддінгів. Чому? Бо тренувалась на image captions, а вони зазвичай короткі — "man walking a dog", "red car on the road". Жодних довгих описів у тренувальних даних не було, тому модель не навчилася витягувати семантику з довгих текстів.
Що кажуть пейпери? Long-CLIP research явно показала, що у CLIP effective token length — це ~20 токенів — після цього продуктивність різко падає. Можете подавати їй 77 токенів — модель їх прийме, але реально вона використовує тільки початок цієї секвенції токенів.
Як це виглядає у ваших даних? Уявіть документ з картинкою і детальним підписом: "Діаграма показує розподіл військових частин по регіонах України станом на третій квартал 2024, з розбивкою за чисельністю особового складу та типом підрозділу". Це ~20 слів, або ~30-35 токенів. CLIP "прочитає" перші кілька слів ("Діаграма показує розподіл військових частин") і згенерує embedding на основі них. Решта опису — про регіони, квартал, особовий склад — фактично загубиться.
Аналогічно з запитами. Ваш "concise user query" — це насправді 4–5 слів, не більше, бо довше CLIP не розуміє. "Знайди діаграму" — працює. "Знайди діаграму розподілу військових частин по регіонах з даними за 2024" — ви отримуєте ембединг слова "діаграма" і кількох наступних, решта буде проігнорована.
Проблема 2: text-only retrieval хромає
Це найменш очевидна з трьох проблем. Саме тому вона б'є чи не найбільше по jebaloo — типова траєкторія, як я можу сказати з власного досвіду, приблизно така: ви тестуєте CLIP на cross-modal демо ("знайди фото кота за словом cat"), бачите що робе, і радісно екстраполюєте на весь корпус.
Тільки коли система вже у проді і користувачі строчать text-only запити по text-only документах — виходить, що короч габели і ви приїхали.
Що відбувається? У CLIP дуже слаба продуктивність text embeddings у text-only retrieval сценаріях — тобто коли ви шукаєте текст по тексту, без жодних картинок. Причина: image captions — це дуже вузький стиль тексту. "Red car", "man in a hat", "cat on a sofa" — коротко, описово, без термінології, без абстрактних концепцій, без технічного жаргону. CLIP натренований розпізнавати цей стиль і тільки його. Ніби як, черговими трюками із димом і дзеркалами можна спробувати це мітігейтнути, але вийде відверто гірше, ніж у спеціалізованих рішеннях, про які писали раніше.
Цифри для тих, хто не вірить на слово. У пейпері Jina CLIP (де якраз і вирішували цю проблему) є прямий замір на MTEB retrieval — це 58 датасетів text-to-text пошуку, фактично стандарт для оцінки текстових ембеддінгів. OpenAI CLIP набирає на ньому 0.162 середнього скору.
Для порівняння: jina-clip-v1, який спеціально донавчили виправити цю діру, тягне 0.429 — і автори чесно пишуть, що це +165% над базовим CLIP. А спеціалізовані текстові моделі типу e5-large чи jina-embeddings-v2 живуть у районі 0.50+. Тобто розрив між CLIP і нормальною текстовою моделлю — приблизно 3x, а не "трошки гірше, нормальний бейзлайн, потім поміняєм".
Тобто, мова йде не про наносекундну різницю в latency, як ми говорили в тексті про пошуковики — це буквально різниця між "знаходить" і "не знаходить".
Як це впливає на реальну систему? Уявіть у вас RAG-систему, де частина запитів — "знайди картинку з такою схемою" (cross-modal), а частина — "знайди документ про процедуру X" (text-only). Ви взяли CLIP, щоб обслуговувати обидва типи однією моделлю, патамуша ж економія і менший інжерний оверхед.
Виходить: cross-modal працює ок. Text-only працює гірше, ніж якби ви просто взяли звичайну text embedding-модель типу e5-large. Тобто CLIP для змішаного корпусу — це не "одна модель замість двох", а "дві гірші замість однієї хорошої". Ви виграли приблизно ніфіга, і ваш МЛ-інженер йде в глядацький зал.
Практичний висновок. Не тримайте CLIP як універсальну ембеддінг-модель для системи з text-heavy retrieval. Або вона спеціалізована тільки на cross-modal — і тоді у вас окрема text-only модель паралельно — або ви взагалі використовуєте щось інше (див. секцію нижче).
Проблема 3: compositional reasoning
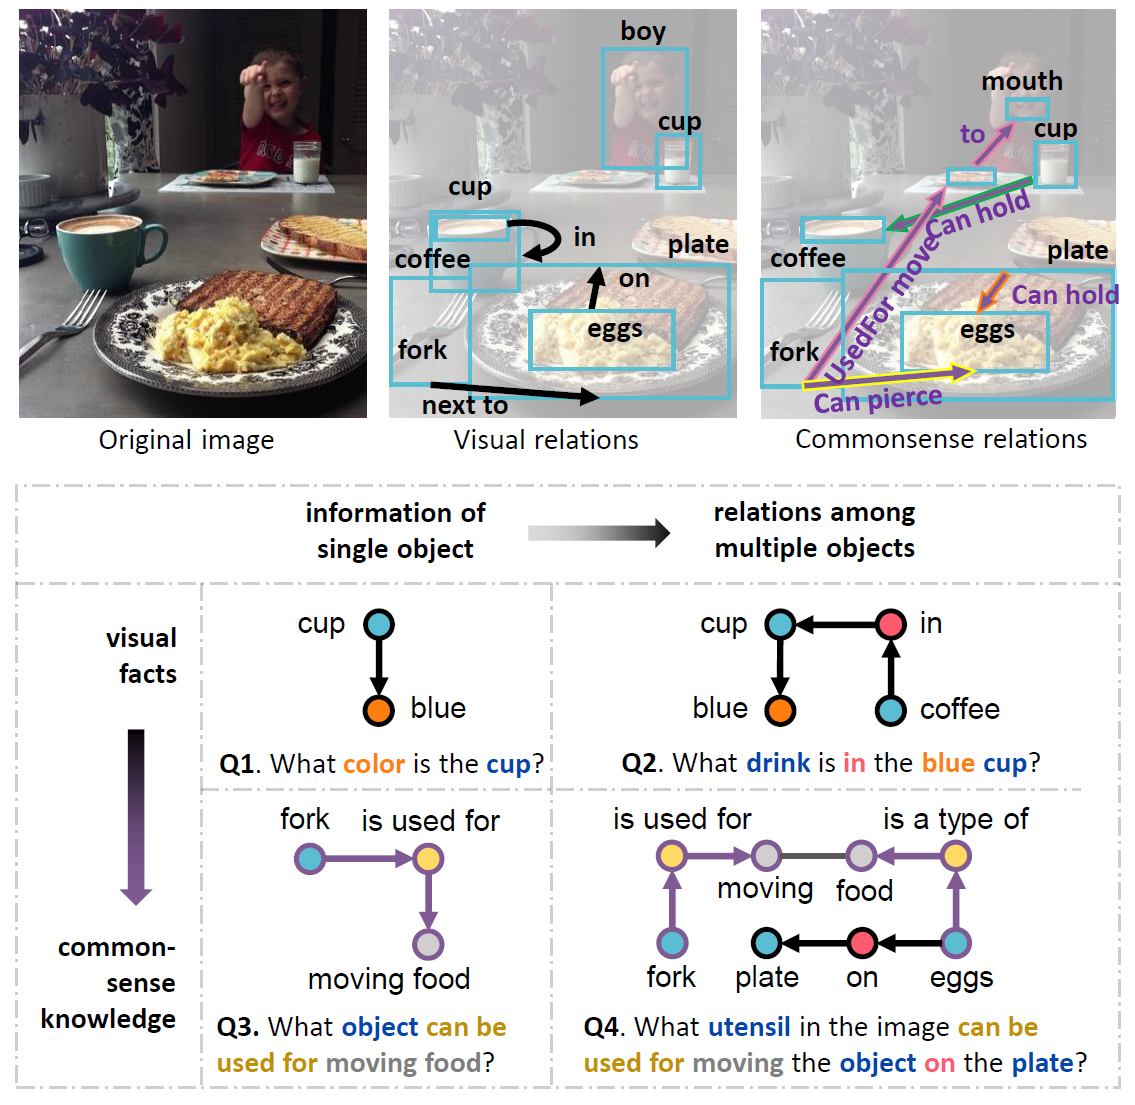
Найболючіша з трьох. І найглибша — це не просто обмеження тренування, це фундаментальна проблема того, як CLIP-подібні моделі "уявляють світ".
Що відбувається? Мультимодальні моделі досить непогано розпізнають об'єкти — що на картинці є телефон, карта, людина, машина. Але реляції між цими об'єктами — хто і що як співвідноситься з іншими об'єктами, як вони взаємодіють — вони розпізнають дуже погано.
Класичний приклад з досліджень — Winoground. Бенчмарк, де моделям показують дві картинки і два підписи з тими самими словами, але в різному порядку: "phone on a map" і "map on a phone".
Об'єкти ті самі, реляція протилежна, умовно. Людина розрізняє миттєво — точність ~89% по всіх метриках бенчмарку. CLIP-подібні моделі (CLIP, FLAVA, UNITER — усі великі гравці на момент 2022) дають 30–35% на text/image score при випадковому бейзлайні 25%. Тобто ледь-ледь підіймаємося над підкиданням монетки.
А на group score, де треба правильно зіставити обидві пари одночасно — нижче 15%, тобто гірше за рандом. І це не якась експериментальна модель — це OpenAI CLIP, той самий, який люди вже потенційно розглядають під продакшен.
Що тут найважливіше, якщо ТЛДР: відтоді минуло чотири роки, прогрес у CLIP-сімействі модельок був суттєвий, але саме по композиційній семантиці він мінімальний.
Усі “фікси” — LongCLIP, SDS-CLIP (дистиляція зі Stable Diffusion), навіть прикручування GPT-4V — додають одиниці-десятки відсотків зверху, не закриваючи розрив до людського рівня. Той самий SDS-CLIP, цілий пейпер з нетривіальним методом, дає всього +1,5–7% на Winoground. Треба розуміти, що це не обмеження якоїсь конкретної моделі чи покоління моделей навіть — це фундаментальне обмеження парадигми contrastive learning з image captions.
Чому це важливо для реальних систем? Уявіть RAG-систему для технічної документації, де часто зустрічаються діаграми. Запит: "знайди документ де таблиця знаходиться під діаграмою пояснення методології". Якщо у вас є правильний документ з таблицею під діаграмою і неправильний з діаграмою під таблицею — CLIP embedding їх не розрізнить. Обидва містять "таблицю" і "діаграму" як об'єкти, обидва отримають схожі embeddings, модель вам поверне обидва з майже однаковою впевненістю.
Для пошуку з композиційною семантикою — а це реально купа юзкейсів у документному пошуку, технічній документації, e-commerce з атрибутами — сімейство моделей CLIP працює десь на рівні підкидання монетки. Нє, ну зате інференс робить вжжж, і ви палите ліси Амазонки для отримання свого нічого, та і начальству буде що показати.
Як це обходити у реальній системі?
Окей, ви вже в курсі, що все, що може зламатися, зламається, і що може піти не так — піде не так. Два слова про те, як з цим жити. Якщо вам все-таки треба працювати з зображеннями у production RAG — є чотири практичних підходи, в порядку збільшення складності і якості:
1. Caption + text embedding (найпростіше, часто достатньо)
Ідея. Замість embedding картинки напряму через CLIP — згенерувати детальний текстовий опис картинки через vision-language модель (GPT-4V, LLaVA, Claude з vision), потім embedding цього опису через звичайну text-модель типу e5-large або jina-embeddings-v3.
Трейдофф. Ви втрачаєте швидкість при інгестії (додатковий LLM call на кожну картинку — це не зовсім дешево, селф-хостед чи ніт). Але виграєте: якість retrieval (звичайні text-моделі набагато кращі за CLIP на тексті), можливість працювати з довгими запитами (не обмежені 20 токенами), compositional reasoning (LLM описує "таблиця ПІД діаграмою" буквально цими словами, і text-модель це розуміє).
Коли це правильний вибір? Для більшості non-computer-vision задач це правильна опція за замовчуванням. Якщо ви не будуєте Google Images чи e-commerce visual search — почніть з цього варіанту. Інтегрується в існуючий text RAG pipeline без переробки архітектури, я особисто використовую саме таке для мультимедіа-контенту, який є (або потенційно буде) в моїй системі.
2. Сучасні CLIP-альтернативи
Якщо вам треба швидкий native multimodal (справжні image embeddings, не через caption), але не хочеться мучитись з обмеженнями оригінального CLIP — беріть одного з наступників.
Jina CLIP v1 покращила оригінал на +165% у text-only retrieval і +12% у image-to-image при порівняльній продуктивності у cross-modal. Фактично закриває проблему №2, хоча на мій смак мішані системи все одно ліпше
Jina CLIP v2 йде ще далі з multilingual support — 89 мов, включно з українською, якщо не помиляюсь. Якщо ваш корпус не англомовний, це майже обов'язковий апґрейд. Про болі з менш частотними мовами тут пишеться мало не в кожній статті.
Коли вибирати. Якщо ви визначилися, що вам конче треба, але хочете уникнути пасток оригінального CLIP. Дроп-ін заміна в більшості випадків, просто не думаючи.
3. Late interaction (ColPali)
Ідея. Замість одного embedding на всю картинку — ColPali генерує ~1030 patch embeddings (для кожного шматочка картинки окремо) і робить late interaction з текстовими токенами запиту. Тобто при пошуку порівнюються не глобальні ембеддинги картинки і тексту, а кожен patch картинки з кожним токеном запиту окремо, і агрегується максимум.
Трейдофф. Значно дорожче по сховищу (для типової сторінки PDF — цифри порядку 1000 ембеддінгів замість одного) і по compute (порівнюємо патчі з токенами, а не вектори з векторами). Але дає значно кращий retrieval в обидва боки і краще справляється з compositional reasoning, бо патчі зберігають локальну структуру.
Окремий неочевидний плюс: ColPali не вимагає попереднього OCR і chunking — ви годуєте йому сторінку “як зображення”, і він сам розбирається. Якщо у вас pipeline з PDF, де OCR — це окрема головна біль, цей плюс часто компенсує overhead по сховищу.
Коли вибирати? Для документного пошуку з візуальними елементами — PDF з таблицями, графіками, складним layout — це найкраще, що є сьогодні, на мою думку. Якщо ви шукаєте наукові статті, технічні документи, презентації — подивіться на ColPali. Але треба сказати, що довбати все можливе в один стор там не дуже вийде, доведеться інженерно гратися із рознесенням цих сутностей або логічно, або по організації, коротше кажучи, з вкладеністю і структурою стореджу і пошуку відповідно, а там свій головняк (див. частину 2 циклу).
4. Dual-embedding approach (якщо ресурси дозволяють)
Ідея. Не вибирати між моделями, а зберігати два embeddings на кожен об'єкт: CLIP embedding (для cross-modal пошуку) і окремий text embedding (для text-only пошуку). При запиті вибираєте, який простір шукати залежно від типу запиту.
Трейдофф. Удвічі більше сховища, удвічі більше support навантаження при інгестії, складніша архітектура з двома векторними індексами. Але значно краща якість на змішаних запитах, бо кожен тип запиту йде у модель, яка для нього оптимізована.
Коли вибирати. Якщо якість критична, ресурси є, і ви не можете дозволити собі "ну трошки гірше text retrieval" — це золотий стандарт. Це варіант для серйозних production-систем з бюджетом.
Що з цього вибирати для сапорт системи?
Для саппорт-автоматизації типу тієї, про яку писали раніше в статтях, які були більше кейс-стаді, мультимодальність поки не критична (переважна більшість тікетів — це текст), інколи — скріншот помилки, але не більше того. Але якщо колись доведеться серйозно підключати картинки — починали б з варіанту (1): caption через vision LLM плюс звичайний text embedding.
Чому саме цей варіант? Найпростіше з усіх чотирьох в інтеграції. Додаткова latency тільки при інгестії, не при пошуку. Працює з існуючим text RAG pipeline без переробки — той самий Qdrant, та сама multilingual-e5-large, та сама RRF логіка. Картинки просто стають ще одним джерелом тексту через caption step.
Якщо use case вимагав би швидкого pure-visual пошуку — "знайди подібну сукню по фото" в e-commerce або "знайди схожий документ за лейаутом" чи “знайди таку-то діаграму" — тоді варіанти (2)–(4) релевантні. Але для більшості RAG-систем "просто візьми caption" — це правильна відповідь.
Загальний принцип. "Просто візьми штуку з демо" — це хороший спосіб розчаруватися через пару місяців, коли система попадає в продакшен. Ті самі три проблеми, які я описували вище — обмеження токенів, text-only деградація, compositional reasoning — рано чи пізно вилізуть на вашій конкретній системі, якщо про це не подумати заздалегідь
На цьому серія про векторні БД і RAG в цілому закруглюється. Ми пройшли чималенький шлях, і мені треба буде трохи подумати, що писати далі. Закриємо цей цикл невеликим додатком про GraphRAG і кількома моїми думками про нього, а там буде видненько.