
Si tu fais du trading algo sur Hyperliquid avec Freqtrade, tu as forcément rencontré ce problème : comment récupérer assez de données historiques pour backtester sérieusement ? Hyperliquid limite le téléchargement à 5000 bougies en arrière par timeframe. En 5 minutes, ça fait environ 17 jours. Pas de quoi faire un backtest digne de ce nom.
Pendant un moment, la communauté utilisait le repo GitHub d'Hippocritical pour récupérer les données. Ça marchait bien — jusqu'au jour où ça s'est arrêté. Il a fallu trouver une autre solution. Ce post retrace le parcours complet : le problème, la transition, et comment mettre en place un système autonome qui tourne en crontab tous les jours.
Si tu débutes avec Freqtrade, je te recommande de lire d'abord le guide complet des backtests et le guide de connexion Freqtrade + Hyperliquid.
Le problème de fond : la limite des 5000 bougies
Hyperliquid est un excellent exchange pour le live — décentralisé, rapide, frais compétitifs. Mais côté données historiques, c'est une autre histoire.
L'API Hyperliquid impose une limite stricte de 5000 bougies par requête et par timeframe. Concrètement, voici ce que ça donne en profondeur d'historique :
5m : 5000 × 5 min = ~17 jours
15m : 5000 × 15 min = ~52 jours
30m : 5000 × 30 min = ~104 jours
1h : 5000 × 60 min = ~208 jours
4h : 5000 × 240 min = ~2.3 ans
1d : 5000 × 1 jour = ~13.7 ans
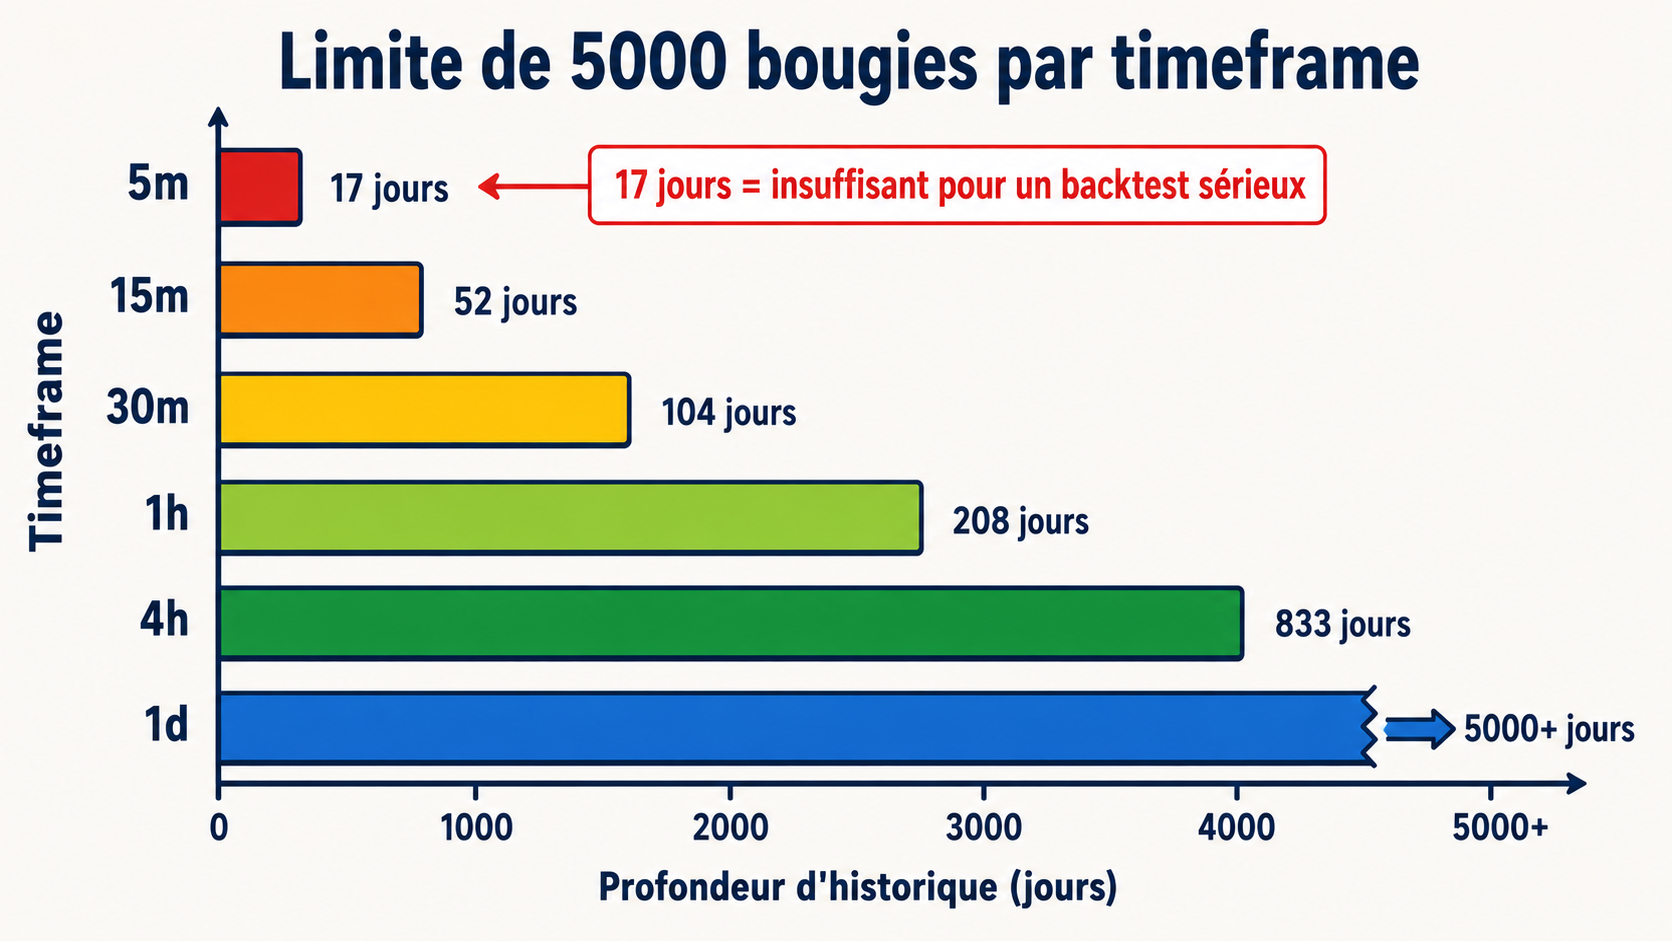
Tu vois le problème : en 5m, tu ne peux récupérer que 17 jours de données. Si tu lances un freqtrade download-data aujourd'hui et que tu veux backtester sur 6 mois, c'est tout simplement impossible via l'API. Et même en 1h, tu es limité à ~7 mois.
En plus de cette limite de profondeur, il y a le rate limit : Hyperliquid autorise 1200 requêtes par minute par wallet. Quand tu télécharges les données de 300+ paires sur 8 timeframes, ça s'additionne très vite.
L'ancienne solution : le repo d'Hippocritical
Pendant plusieurs mois, la communauté Freqtrade avait une solution élégante : le repo GitHub d'Hippocritical (frequenthippoOrg/freqtrade_hyperliquid_download-data). Il mettait à disposition les données OHLCV pré-téléchargées pour toutes les paires Hyperliquid, mises à jour régulièrement via GitHub Actions.
On avait d'ailleurs écrit un post dédié pour expliquer comment l'utiliser — comment cloner le repo, créer un symlink, et automatiser la mise à jour.
Ça marchait très bien. Jusqu'au jour où Hippocritical a arrêté de mettre les données à jour. Le repo n'est plus maintenu activement. Les GitHub Actions ne tournent plus. Et les données sont figées à une date qui recule de plus en plus dans le passé.
Résultat : des données périmées, et plus moyen de backtester avec des données récentes sur Hyperliquid.
La solution : télécharger soi-même, tous les jours
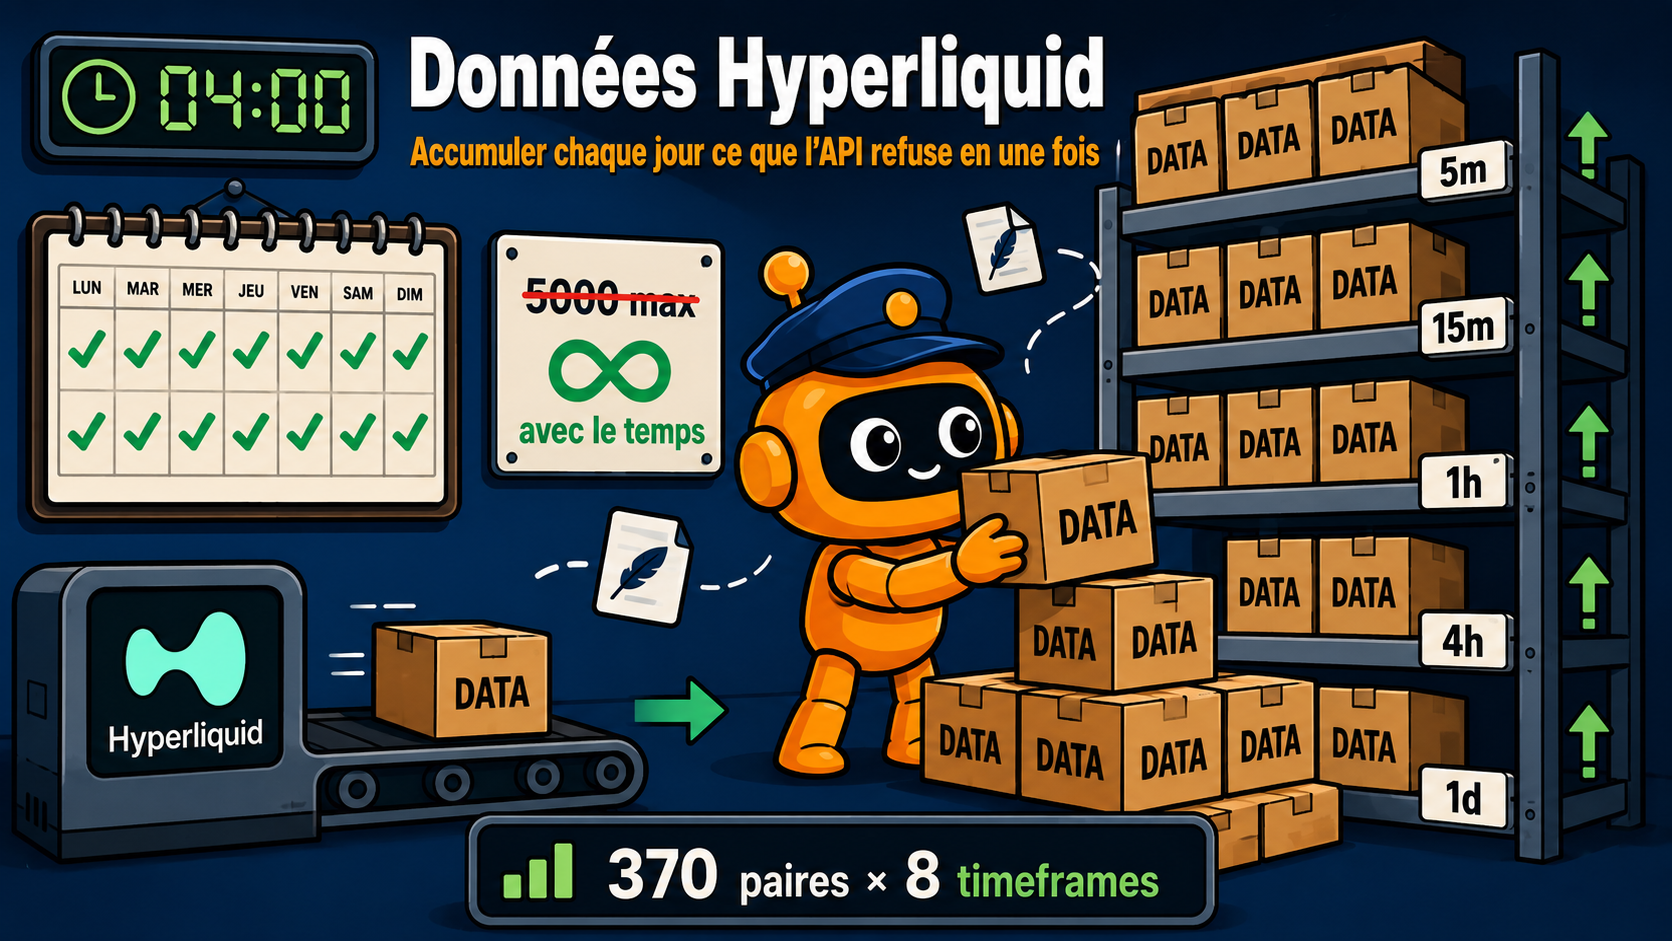
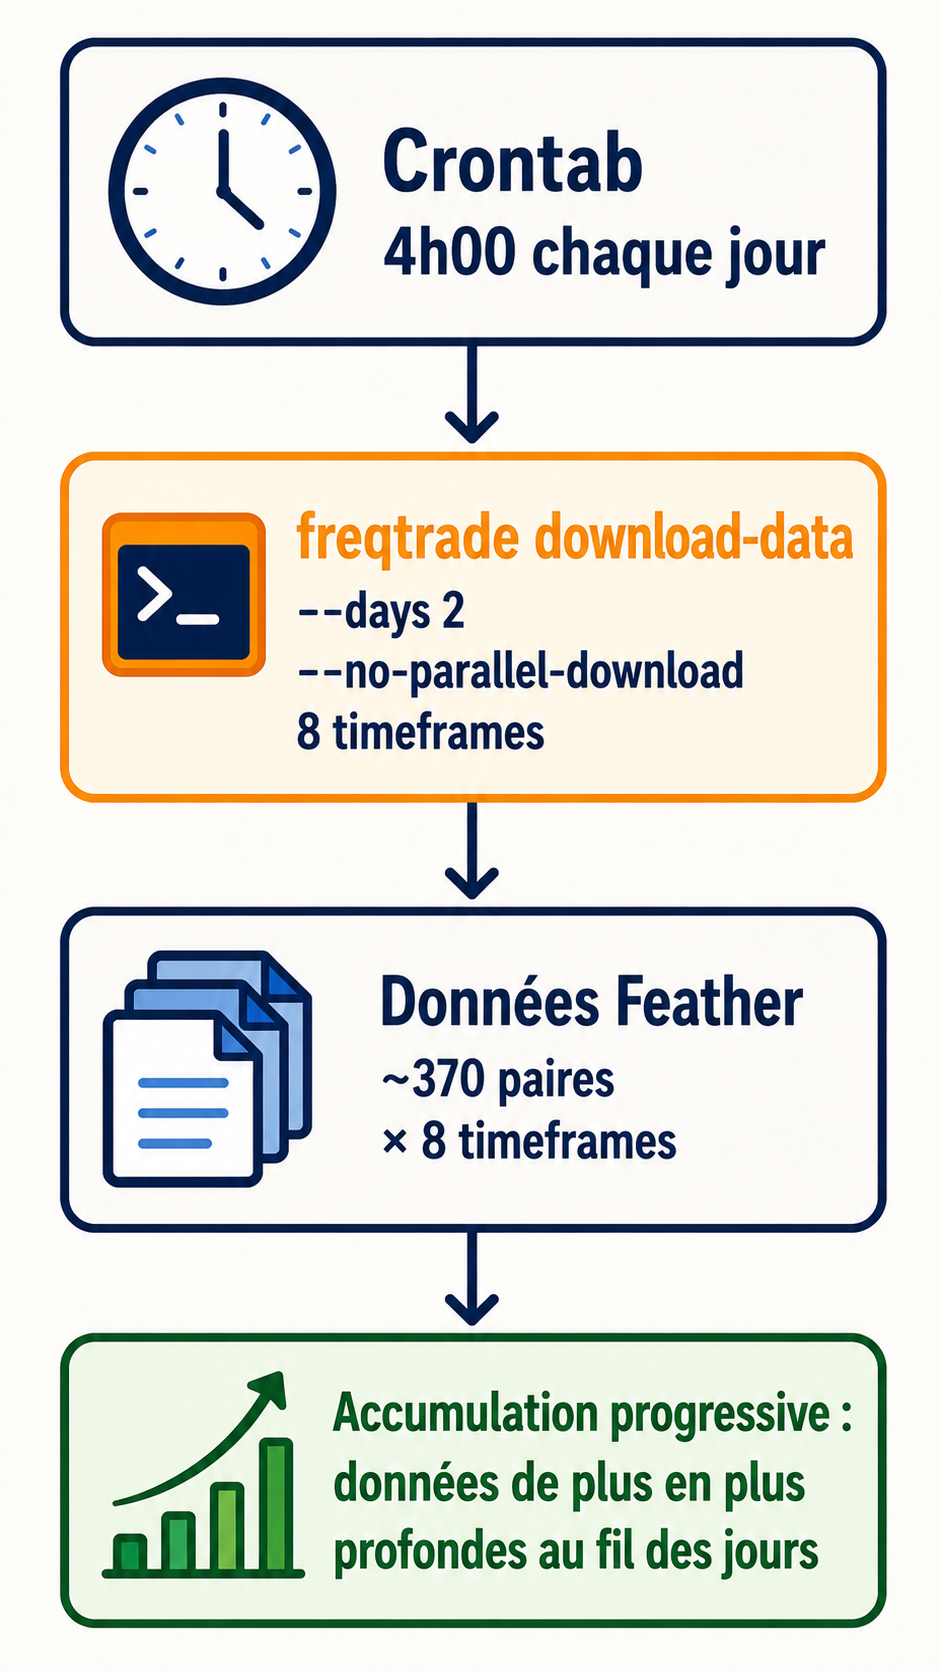
Le raisonnement est simple : si Hyperliquid ne donne que 5000 bougies en arrière par timeframe, il faut télécharger un peu tous les jours et accumuler les données au fil du temps.
Le crontab suivant exécute cette commande tous les jours à 4h du matin :
0 4 * * * cd /home/moutonneux/freqtrade && \
  .venv/bin/freqtrade download-data \
  -c backtest_configs/hyperliquid_download_data.json \
  -d user_data/data/hyperliquid \
  --pairs-file backtest_configs/hyperliquid_pairs.json \
  -t 5m 15m 30m 1h 2h 4h 1d 1w \
  --days 2 \
  --data-format-ohlcv feather \
  --no-parallel-download \
  >> /tmp/hl_download_data.log 2>&1
Décortiquons les paramètres importants :
--days 2: on ne télécharge que les 2 derniers jours de données. Puisqu'on tourne tous les jours, ça suffit largement pour rester à jour — et ça évite de solliciter l'API inutilement.--no-parallel-download: les paires sont téléchargées séquentiellement, pas en parallèle. C'est plus lent, mais ça réduit drastiquement la pression sur le rate limit. Et comme le crontab tourne à 4h du matin, la vitesse n'est pas un problème.--data-format-ohlcv feather: format Apache Arrow Feather, plus compact et plus rapide à lire que le JSON. C'est aussi le format utilisé par ftcache pour la persistance.-c backtest_configs/hyperliquid_download_data.json: une config dédiée au téléchargement, minimaliste, avec le support HIP-3 activé.
La config de téléchargement
Voici la config utilisée dans le fork (voir sur GitHub) :
{
    "trading_mode": "futures",
    "margin_mode": "isolated",
    "stake_currency": "USDC",
    "dry_run": true,
    "exchange": {
        "name": "hyperliquid",
        "hip3_dexes": ["xyz", "para"],
        "pair_blacklist": []
    },
    "pairlists": [
        {
            "method": "VolumePairList",
            "number_assets": 500,
            "sort_key": "quoteVolume",
            "min_value": 0,
            "refresh_period": 86400
        }
    ]
}
Deux points à noter :
"hip3_dexes": ["xyz", "para"]: cette ligne active le support des paires HIP-3, le standard d'Hyperliquid pour les DEX communautaires (XYZ, Paradigm, etc.). Sans cette config, tu ne télécharges que les paires du DEX principal — tu rates toute une partie du marché.VolumePairListavec 500 paires : pour le téléchargement, autant prendre large. En backtest, on utiliseraStaticPairList, mais pour le download, autant tout récupérer.
La liste de paires est dans un fichier séparé (hyperliquid_pairs.json sur GitHub) — actuellement 246 paires, de BTC/USDC à ZRO/USDC.
Le résultat : les données disponibles dans le fork
Grâce à ce téléchargement quotidien qui tourne depuis des mois, le fork a accumulé un historique qui dépasse largement ce que l'API Hyperliquid permet de récupérer en une seule fois. Voici la profondeur de données actuellement disponible dans le fork :
1w (hebdomadaire) : depuis août 2019 — quasi 7 ans d'historique
1d (journalier) : depuis août 2020 — quasi 6 ans
4h : depuis novembre 2022 — plus de 3 ans
2h : depuis décembre 2023 — environ 2 ans et demi
1h : depuis août 2024 — presque 2 ans
30m : depuis décembre 2024 — environ 5 mois
15m : depuis février 2025 — environ 3 mois
5m : depuis mars 2025 — environ 2 mois
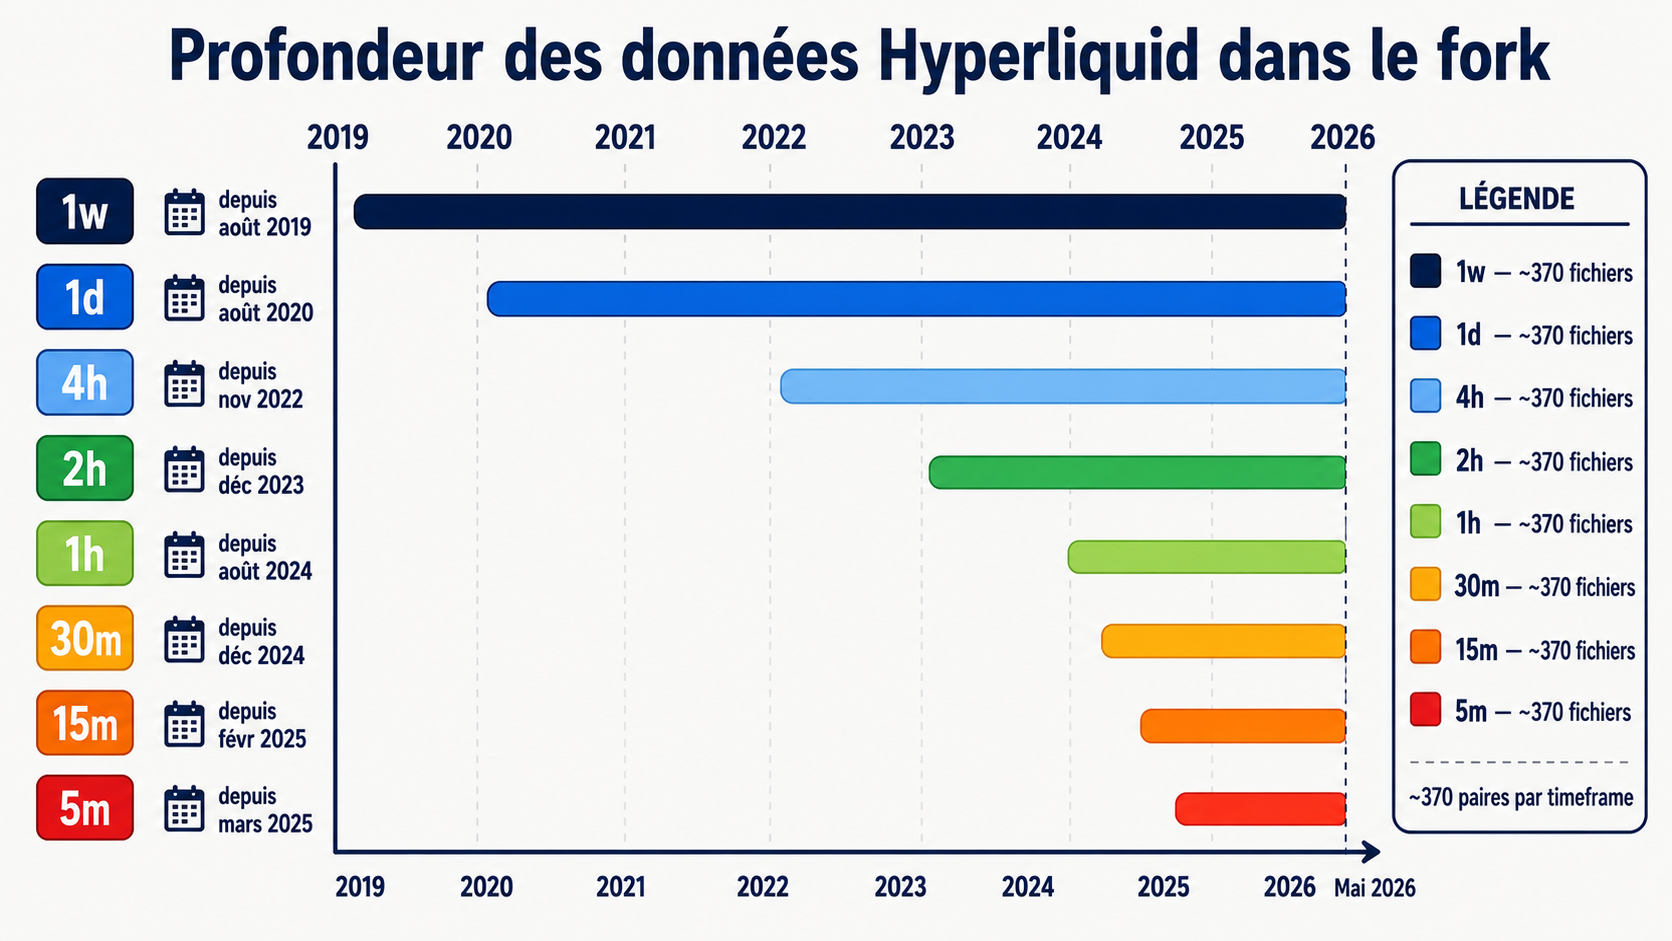
Tu remarques le pattern : plus le timeframe est court, moins l'historique est profond. C'est logique — 5000 bougies en 5m ne font que 17 jours. C'est précisément pour ça que le crontab télécharge tous les jours : chaque jour qui passe ajoute de la profondeur, surtout sur les petits timeframes.
Et c'est aussi pour ça que ces données sont exposées directement dans le repo freqtrade-fork. L'objectif est de permettre à n'importe qui de récupérer des données au-delà de la limite de 5000 bougies, sans avoir à les accumuler soi-même pendant des semaines.
Environ 370 paires sont couvertes, pour 8 timeframes (5m, 15m, 30m, 1h, 2h, 4h, 1d, 1w), en format Feather.
Le problème du rate limit : ftcache et la priorité LOW
En mettant en place ce système de téléchargement quotidien, un nouveau problème apparait vite : le téléchargement des données interfère avec les bots en live.
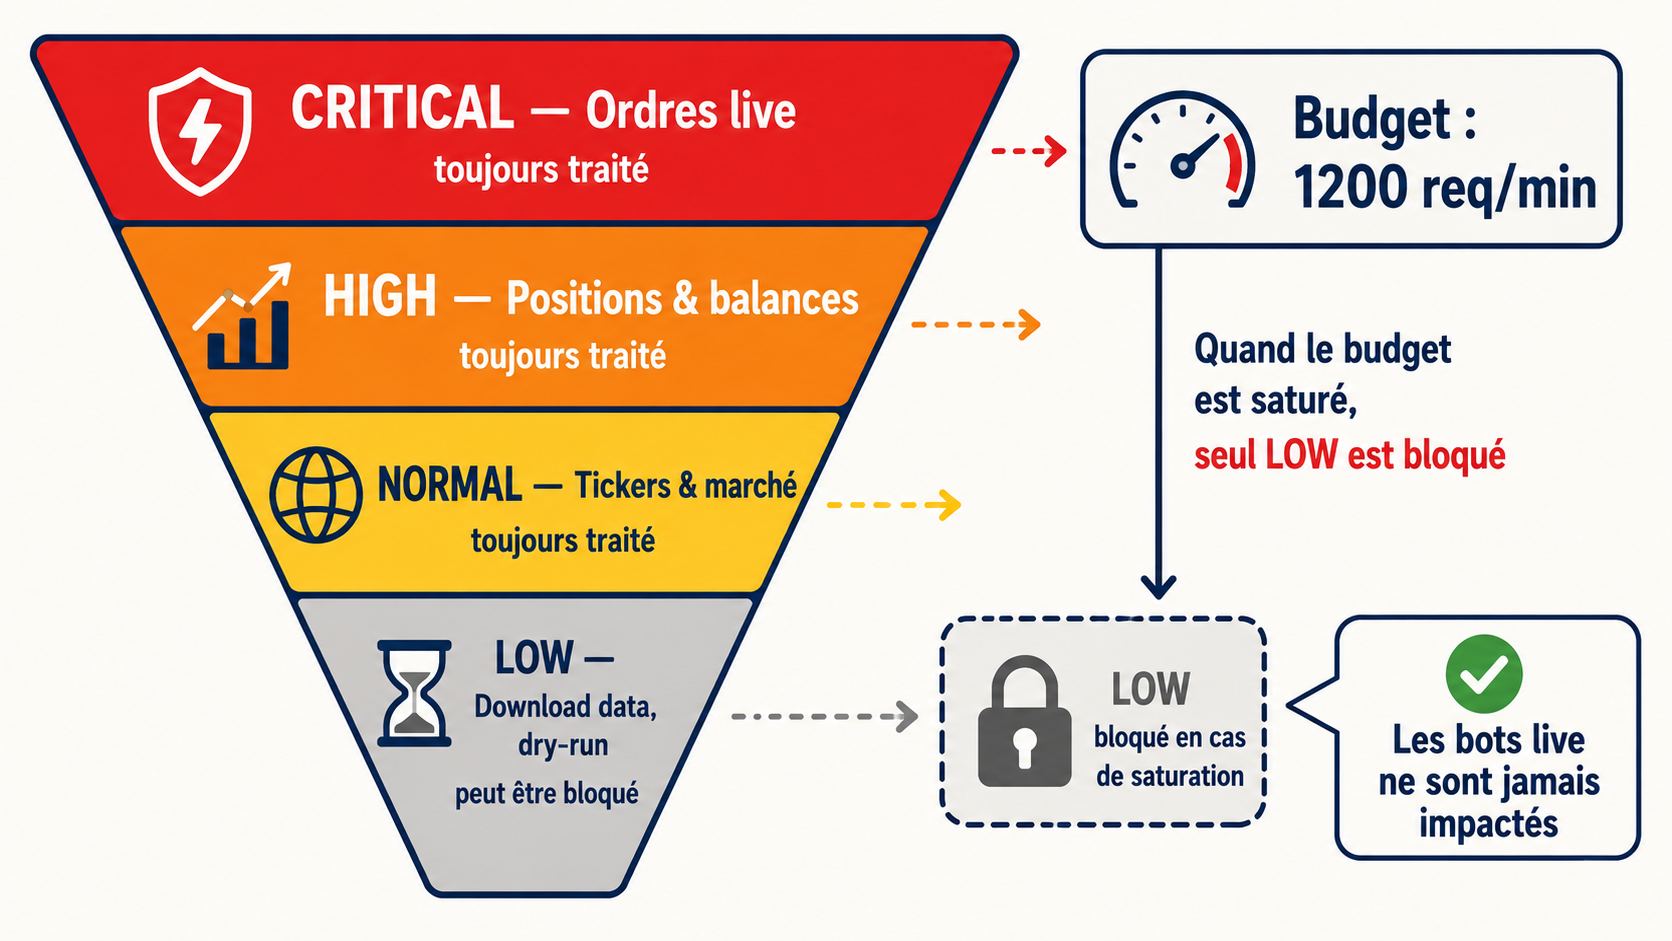
Rappel : Hyperliquid autorise 1200 requêtes par minute par wallet. Les bots live consomment déjà une bonne partie de ce budget. Si en plus le crontab se met à télécharger les données de 370 paires x 8 timeframes au même moment, les bots live se font éjecter par des erreurs 429 (rate limit exceeded).
C'est là qu'intervient ftcache, le cache API intelligent développé dans notre fork Freqtrade.
Comment ftcache protège les bots live
ftcache est un daemon qui centralise toutes les requêtes API de tous les bots Freqtrade. Au lieu que chaque bot appelle Hyperliquid directement, ils passent tous par ftcache qui gère un budget de requêtes partagé avec un système de priorités :
CRITICAL (priorité 0) : passage d'ordres, sorties de positions — jamais retardé, jamais bloqué
HIGH (priorité 1) : consultation des positions, mise à jour des balances pour les trades ouverts
NORMAL (priorité 2) : tickers, infos de marché générales
LOW (priorité 3) : bots en dry-run, leverage tiers, funding rates — et le téléchargement de données
Le code est explicite — quand un bot est en dry_run (ce qui est le cas de la commande download-data), ses requêtes sont automatiquement classées en LOW :
prio = priority if priority is not None else (
    self.LOW if self.dry_run else self.HIGH
)
Le backoff intelligent
Quand le rate limit commence à être tendu (réponse 429 de Hyperliquid), ftcache applique un backoff gradué :
Niveau 1 — SOFT (15 secondes) : seules les requêtes LOW sont rejetées, le débit est divisé par 2
Niveau 2 — MEDIUM (30 secondes) : les requêtes NORMAL et LOW sont rejetées, le débit est divisé par 4
Niveau 3 — HARD (65 secondes) : tout est rejeté sauf CRITICAL
En pratique, ça veut dire que le téléchargement de données à 4h du matin ne dérange jamais les bots live. Si le rate limit est tendu, c'est le download qui ralentit — pas les ordres. Et comme le download est en --no-parallel-download, il consomme très peu de budget API.
Le support HIP-3 : les paires des DEX communautaires
Un avantage de cette méthode par rapport à l'ancien repo d'Hippocritical : le support des paires HIP-3.
HIP-3, c'est le standard d'Hyperliquid qui permet aux DEX communautaires de lister leurs propres paires perpétuelles. Aujourd'hui, il y a plusieurs DEX actifs : XYZ (le principal), Paradigm (PARA), et d'autres comme VNTL ou FLX.
Ces paires apparaissent avec un préfixe dans Freqtrade :
XYZ-AMD/USDC:USDC— une paire sur le DEX XYZPARA-BTCD/USDC:USDC— une paire sur le DEX Paradigm
Pour que le téléchargement inclue ces paires, il faut l'activer explicitement dans la config :
{
    "exchange": {
        "name": "hyperliquid",
        "hip3_dexes": ["xyz", "para"]
    }
}
Sans cette ligne, tu ne télécharges que les paires du DEX officiel Hyperliquid et tu passes à côté d'une partie du marché. Toutes les données HIP-3 sont incluses dans le téléchargement quotidien et disponibles dans le fork.
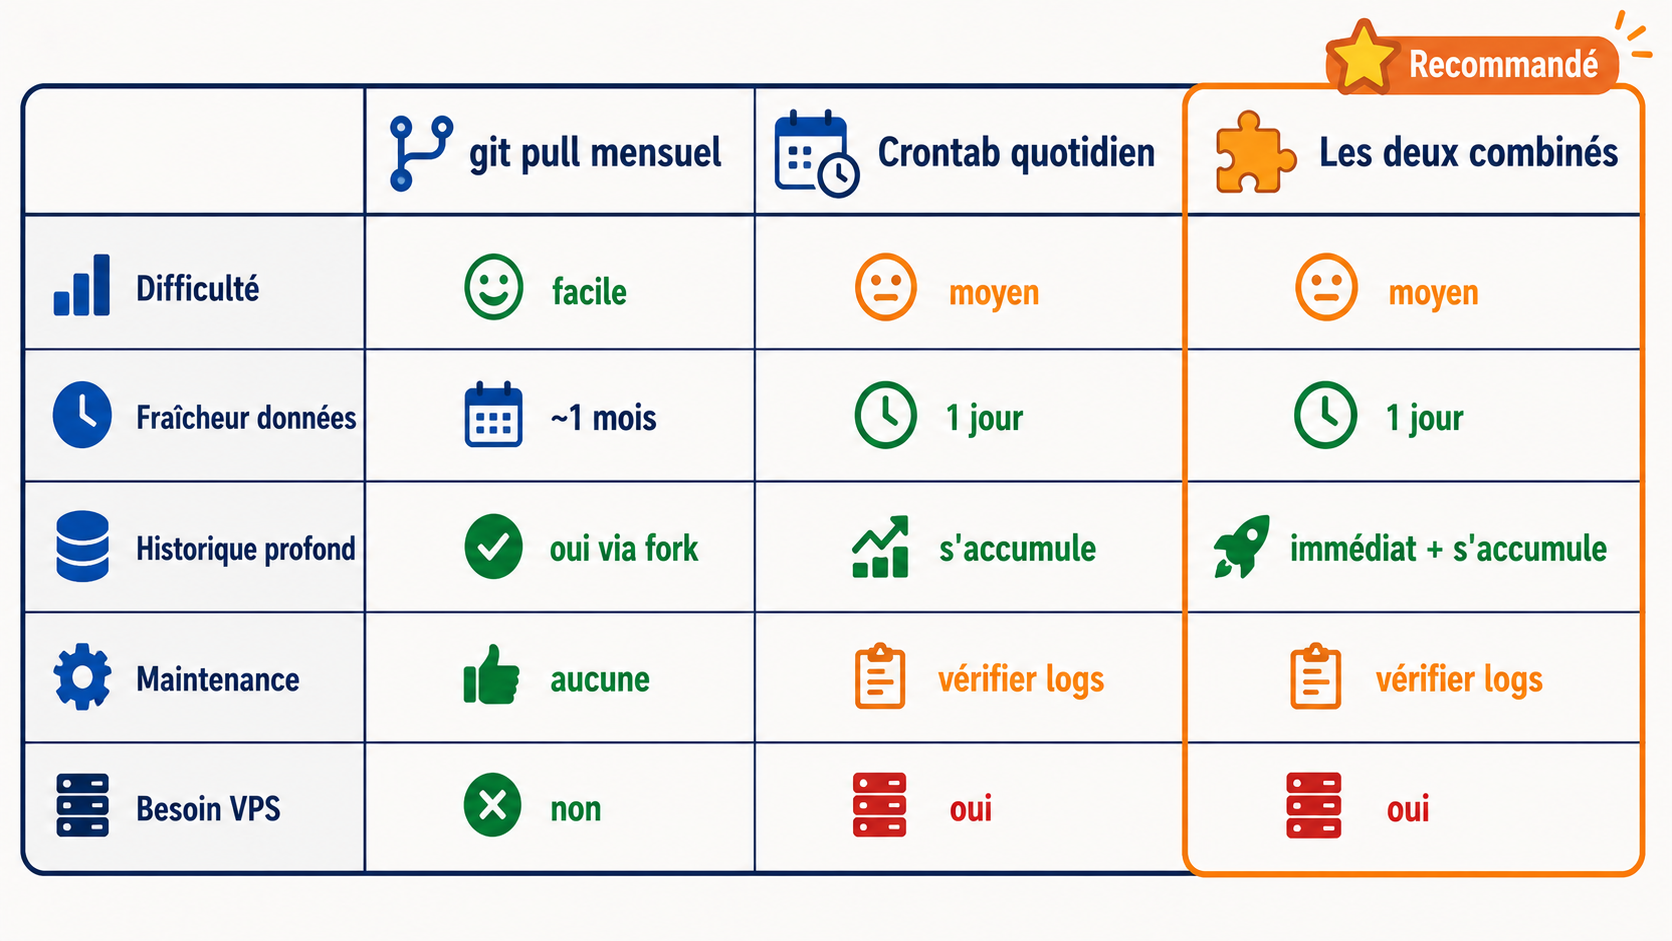
Comment récupérer les données : 3 options
Selon ton niveau de confort technique et tes besoins, tu as trois options.
Option 1 : git pull mensuel (le plus simple)
Si tu ne veux pas t'embêter avec un crontab et que tu n'as pas besoin de données fraîches au jour le jour, c'est la solution la plus simple. Les données Hyperliquid sont mises à jour sur le repo GitHub environ une fois par mois.
# Cloner le fork (première fois)
git clone https://github.com/titouannwtt/freqtrade-fork.git

# Ensuite, pour mettre à jour :
cd freqtrade-fork
git pull
Les données sont dans user_data/data/hyperliquid/futures/. Tu les copies ou tu crées un symlink vers ton dossier de données Freqtrade :
# Symlink vers ton installation Freqtrade
ln -s /chemin/vers/freqtrade-fork/user_data/data/hyperliquid /chemin/vers/ton/freqtrade/user_data/data/hyperliquid
L'avantage : zéro maintenance, zéro configuration API. L'inconvénient : les données ont potentiellement un retard d'un mois par rapport au live.
Option 2 : ton propre crontab (recommandé)
Si tu veux des données toujours à jour, la meilleure approche est de mettre en place un crontab qui télécharge les données tous les jours.
Voici les étapes :
1. Récupère la config de téléchargement et la liste de paires depuis le fork :
# Si tu n'as pas encore le fork :
git clone https://github.com/titouannwtt/freqtrade-fork.git
cd freqtrade-fork

# Les fichiers sont dans backtest_configs/
ls backtest_configs/hyperliquid_download_data.json
ls backtest_configs/hyperliquid_pairs.json
2. Teste la commande manuellement d'abord :
freqtrade download-data \
  -c backtest_configs/hyperliquid_download_data.json \
  -d user_data/data/hyperliquid \
  --pairs-file backtest_configs/hyperliquid_pairs.json \
  -t 5m 15m 30m 1h 2h 4h 1d 1w \
  --days 2 \
  --data-format-ohlcv feather \
  --no-parallel-download
3. Si ça fonctionne, ajoute-le à ton crontab :
crontab -e

# Ajoute cette ligne (adapte le chemin vers ton installation) :
0 4 * * * cd /chemin/vers/freqtrade && \
  .venv/bin/freqtrade download-data \
  -c backtest_configs/hyperliquid_download_data.json \
  -d user_data/data/hyperliquid \
  --pairs-file backtest_configs/hyperliquid_pairs.json \
  -t 5m 15m 30m 1h 2h 4h 1d 1w \
  --days 2 \
  --data-format-ohlcv feather \
  --no-parallel-download \
  >> /tmp/hl_download_data.log 2>&1
Le --days 2 fait que chaque exécution est légère — on ne télécharge que 2 jours de données. C'est rapide et ça met très peu de pression sur l'API. Le --no-parallel-download assure que les requêtes sont espacées pour ne pas saturer le rate limit.
L'avantage : données fraîches chaque jour, historique qui s'accumule automatiquement. L'inconvénient : nécessite un serveur qui tourne (un VPS par exemple).
Option 3 : combiner les deux
C'est l'approche recommandée si tu débutes : commence par un git pull du fork pour avoir immédiatement un historique profond, puis mets en place ton crontab pour rester à jour au quotidien. Le meilleur des deux mondes.
Exemple concret : configs de backtest Hyperliquid
Dans le fork, tu trouveras plusieurs configs d'exemple prêtes à l'emploi pour Hyperliquid dans le dossier backtest_configs/ :
futures_hyperliquid_173.json — config de backtest avec 173 paires, paramètres complets (entry/exit pricing, protections, etc.)
futures_hyperliquid_100.json — version avec 100 paires
futures_hyperliquid_30.json — version réduite avec 30 paires, idéale pour des tests rapides
hyperliquid_download_data.json — config de téléchargement (celle du crontab)
hyperliquid_pairs.json — liste de 246 paires
Et pour le live, un template de configuration d'accès Hyperliquid :
hyperliquidfreqtrade_access_example.json — template avec wallet address, private key, et rate limit configuré
Ces configs sont celles utilisées au quotidien dans le fork. Tu peux les copier et les adapter à tes besoins. Entraîne toujours sur l'exchange cible. Un backtest fait sur Binance ne vaudra rien sur Hyperliquid — les frais, le slippage et la structure du carnet d'ordres sont différents.
Pourquoi tout ça plutôt que la méthode "normale" ?
Tu pourrais te dire : "pourquoi ne pas juste lancer un gros freqtrade download-data --days 365 et basta ?". Parce que ça ne marche pas sur Hyperliquid, pour trois raisons :
La limite de 5000 bougies : en 5m, tu ne peux pas récupérer plus de 17 jours d'historique en une seule passe, peu importe le
--daysque tu mets. L'API te donnera au mieux 5000 bougies.Le rate limit : 300+ paires × 8 timeframes × requêtes paginées = des milliers de requêtes. Même avec un rate limit de 1200 req/min, ça prend du temps et ça risque de perturber tes bots live.
Pas de reprise sur erreur propre : si le download plante à mi-chemin (timeout, rate limit), tu dois tout recommencer. Avec des petits downloads quotidiens de 2 jours, chaque exécution est rapide et fiable.
💡 La philosophie derrière cette approche : petites actions régulières > une grosse action ponctuelle. C'est un peu comme du DCA, mais pour la donnée.
Récap et checklist
Voici le résumé de ce qu'on a couvert :
Le problème : Hyperliquid limite le téléchargement à 5000 bougies par timeframe. En 5m, c'est seulement 17 jours.
L'ancienne solution : le repo d'Hippocritical, qui n'est plus maintenu.
La solution : un crontab quotidien qui accumule les données petit à petit, avec
--days 2et--no-parallel-downloadpour ne pas stresser l'API.ftcache : le daemon qui protège les bots live en classant le téléchargement en priorité LOW — si le rate limit est tendu, c'est le download qui attend, pas les ordres.
HIP-3 : le support des paires des DEX communautaires (XYZ, Paradigm), activé par la config
hip3_dexes.Les données sont dans le fork : 370 paires, 8 timeframes, profondeur allant de 2 mois (5m) à 7 ans (1w). Mises à jour mensuellement sur GitHub.
Pour commencer rapidement :
Clone le fork pour récupérer immédiatement les données historiques
Mets en place ton crontab pour rester à jour (ou fais un
git pullmensuel si tu préfères la simplicité)Utilise les configs d'exemple pour lancer tes backtests
Si tu utilises nos forks Freqtrade et FreqUI, tu bénéficies aussi de ftcache intégré nativement pour le scaling multi-bots en live.
⚠️ Rappel obligatoire : un backtest ne vaut rien, ce qui vaut quelque chose c'est le live ! Les performances passées ne préjugent pas des performances futures. Ces outils te donnent les moyens de tester sérieusement — pas de garantir des gains.
💡 Si tu veux essayer Hyperliquid, tu peux passer par ce lien d'affiliation — ça te donne une réduction sur les frais de trading.
⚠️ Disclaimer : cet article est un partage d'expérience et ne constitue en aucun cas un conseil en investissement. Le trading algorithmique comporte des risques de perte en capital. Fais toujours tes propres recherches avant de trader.