

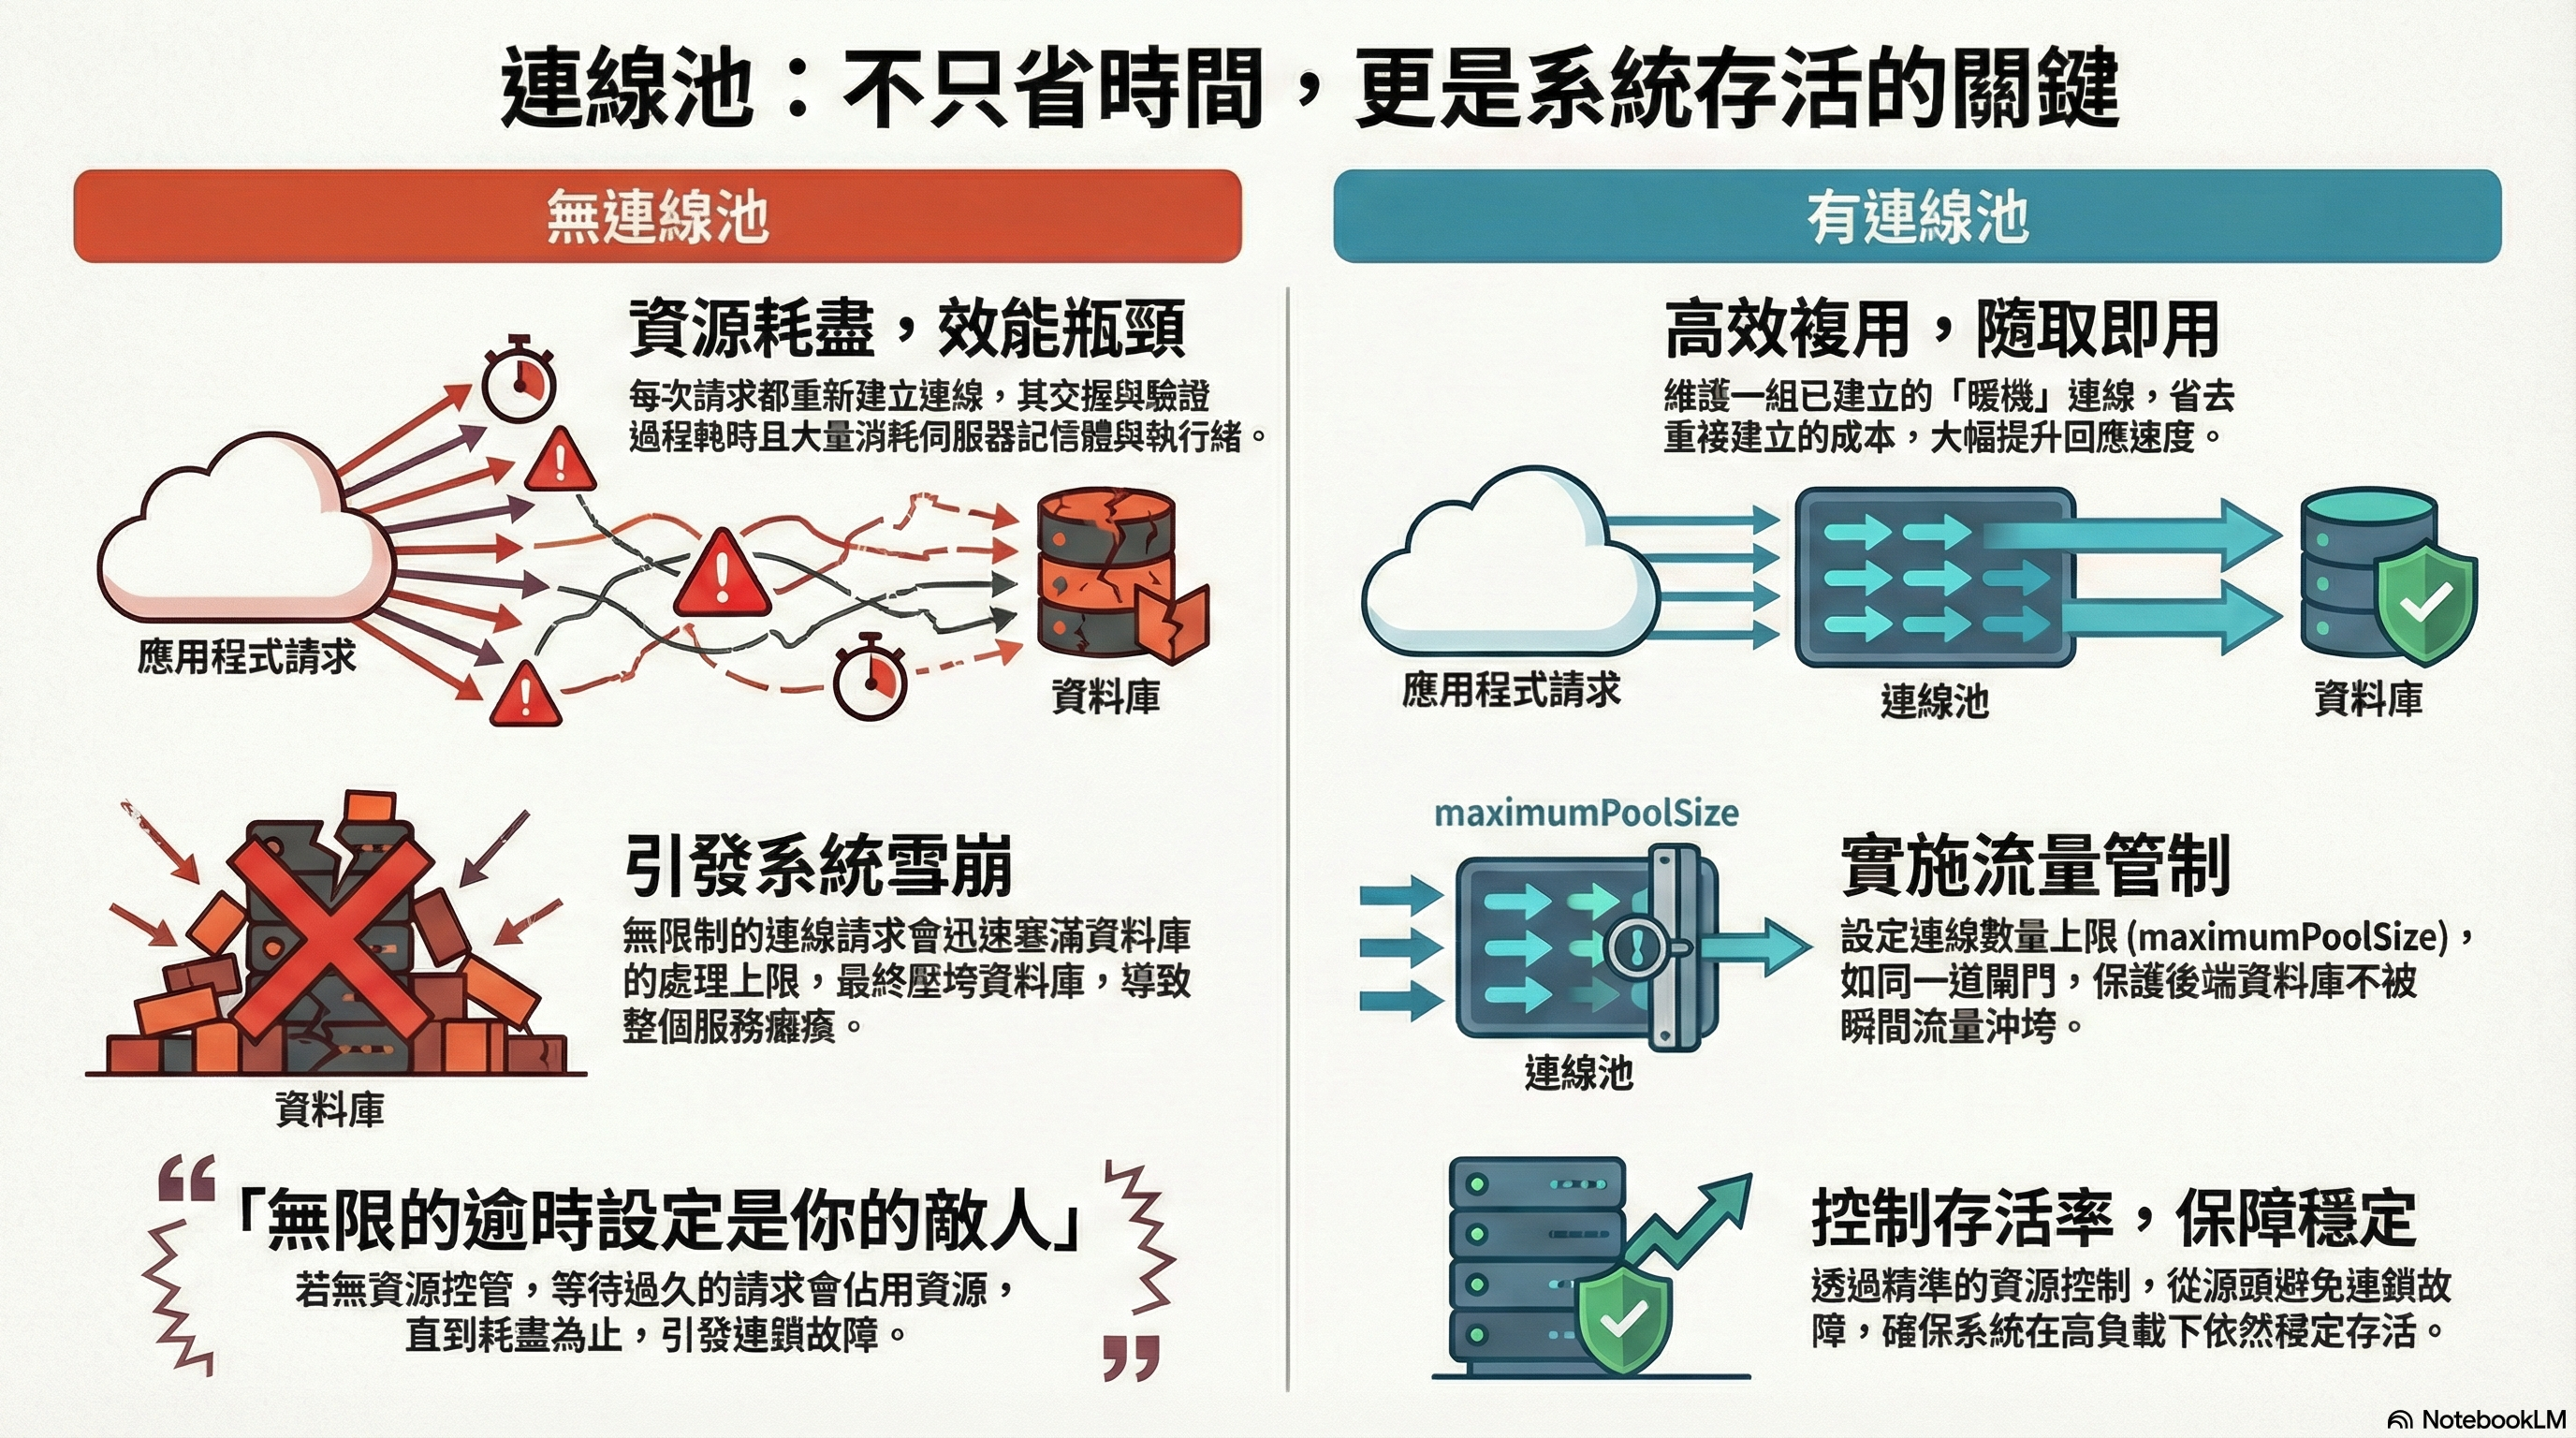
Connection Pooling(連線池)通常被介紹成一句話:
「避免每次請求都重新建立連線,提高效能。」
這句話不算錯,但嚴重低估了它在系統設計中的地位。
在真實的大型系統裡,Connection Pooling 不是效能優化,而是:
一個用來限制失敗擴散、保護下游、控制資源耗盡的核心機制
如果你只把它當成「加速工具」,你很容易在流量一上來時,把整個系統一起拖死。
一、先講清楚本質:Connection 是一種「昂貴資源」
無論是:
Database Connection(TCP + Auth + Session)
HTTP Keep-alive
gRPC / HTTP2 Stream
Redis / MQ 連線
Connection 都不是免費的。
建立一個連線,通常涉及:
TCP handshake(甚至 TLS)
認證與權限驗證
Server-side state allocation
File descriptor / thread / memory 佔用
所以 Connection Pool 的第一個目的是:
限制「同時存在的連線數量」
不是為了快,而是為了不要失控。
二、Connection Pooling 真正在做的三件事
1️⃣ 重用(Reuse)
避免頻繁建立 / 關閉連線,降低延遲與 CPU 消耗。
2️⃣ 限流(Throttling)
強制限制可以同時使用下游資源的請求數量。
Pool size = 你願意讓下游承受的最大壓力
3️⃣ 隔離(Isolation)
當下游慢或故障時,把影響限制在「拿不到 connection 的請求」,而不是整個系統。
這一點極其重要,但常被忽略。
三、為什麼「多加一個服務,穩定性反而下降」?
這裡直接接到你前一篇文章的主題。
當你有這樣的結構:
API → ServiceA → ServiceB → Database
每一層如果都有 Connection Pool,事情就變成:
API 有 200 worker
Service A pool size = 50
Service B pool size = 30
DB max connections = 100
只要有一層配置不合理,就會出現:
上游大量 thread/blocking
Pool 等待堆積
Timeout + Retry 疊加
連線風暴(Connection Storm)
結果不是「慢一點」,而是雪崩式失敗。
四、Connection Pool 最常見、也最致命的誤解
❌ 誤解一:Pool 越大越好
錯。
Pool 太大會:
壓垮下游(DB / Service)
增加 context switching
讓 tail latency 爆炸
Pool size 是一個風險邊界,不是效能旋鈕。
❌ 誤解二:Timeout 設大一點就好
錯。
Timeout 越大:
Thread/blocking 越久
Pool 被占滿的時間越長
上游資源耗盡得越徹底
在高負載下,大 Timeout 等於慢性自殺。
❌ 誤解三:Retry 是保險
Retry 在沒有 Connection Pool 保護的情況下,
只是在對一個已經喘不過氣的系統 補刀。
五、Connection Pool 與系統穩定性的關係(這段很關鍵)
你可以把 Connection Pool 想成:
系統裡的「閘門」
閘門關得太鬆 → 下游被淹死
閘門關得太緊 → 上游排隊爆炸
閘門沒有設計 → 整個系統一起死
好的 Pool 設計,目標只有一個:
讓系統在壓力下「變慢」,而不是「直接死掉」
六、在 vibe coding / AI coding 時代,特別容易踩的坑
這一段是給「用 AI 快速堆系統」的人看的。
🚨 坑 1:AI 生成的預設 Pool 設定「看起來合理」
例如:
maxConnections:100
但 AI 不知道你的:
CPU core 數
DB 能撐多少
每個 request 的 fan-out
是否同步 blocking
這個數字如果亂給,等於隨機下注系統穩定性。
🚨 坑 2:vibe coding 常忽略「釋放連線」
常見問題:
exception path 沒 close
async flow 中忘記 release
connection leak 在低流量時完全看不出來
結果是:
系統上線幾小時後「突然全部卡死」
🚨 坑 3:多層 Pool 疊加,卻沒整體視角
AI 很擅長幫你:
DB pool
HTTP client pool
Redis pool
但它不會幫你算整體系統的連線拓撲。
你必須自己回答:
一個使用者請求,最多會消耗幾個 connection?
七、實務上該怎麼「正確」使用 Connection Pool?
✅ 原則一:從下游能力反推 Pool Size
不是從「上游流量」推。
✅ 原則二:Pool 滿了要 Fail Fast
寧可快速拒絕,也不要慢慢拖垮。
✅ 原則三:Timeout < 上游 Timeout
避免請求卡在中間層。
✅ 原則四:把 Pool 當成穩定性工具,不是效能工具
這個心態,會直接影響你整個系統的壽命。
八、總結一句話
如果你只記得一件事:
Connection Pooling 不是為了讓系統跑更快,而是為了讓系統不要一起死。
在 vibe coding、AI 加速開發的時代:
程式碼可以快
架構不能隨便
Pool 是你最後的防線之一
這不是優化細節,
這是系統能不能活下來的底層設計選擇。